来源:papers/iVc/DCVC_精读02_Figure1与引言贡献.md · 原始 Markdown
DCVC 精读第 2 轮 Figure 1 与引言贡献
本轮接续正式版第 2 页,依次阅读 Figure 1 与图注、引言第 3 段、第 4 段,以及贡献导语和四项贡献,至 Introduction 结束。正文采用短摘录、段落释义与深入讲解;不将释义标为全文翻译。材料为 NeurIPS 2021 正式版。
本轮要掌握的是:同一份特征上下文分别帮助形成表示、重建图像、估计概率;运动对齐使参考特征与当前内容更相关;作者的创新主张需要与已有条件编码工作区分。
Figure 1 原图与图注释义
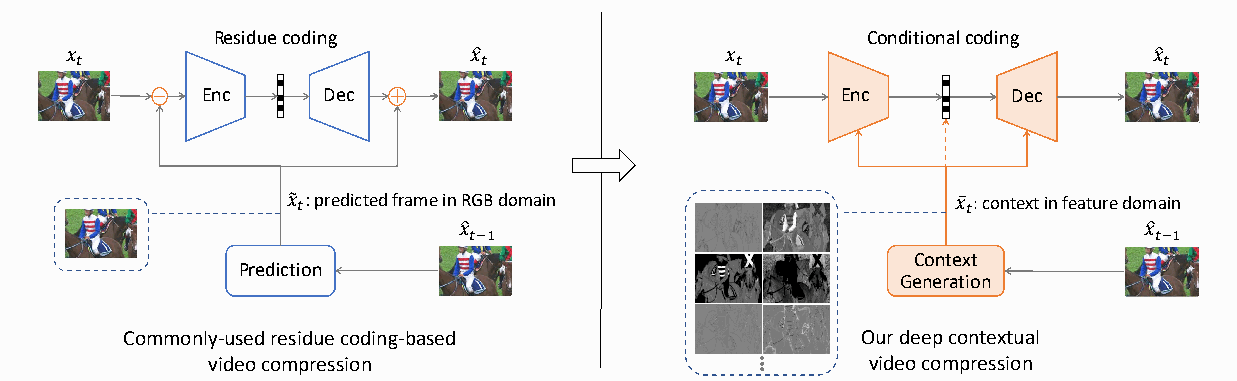
原图直接裁自正式版第 2 页顶部,未重绘。图注表达的是由残差编码框架向条件编码框架的转变。x_t 为当前帧,x_hat_t 与 x_hat_{t-1} 为当前及上一重建帧;橙色虚线表示上下文还用于熵建模。
左侧的数据流
- 从上一重建帧 x_hat_{t-1} 生成 RGB 域的预测帧 x_tilde_t。
- 当前帧 x_t 与预测帧相减,得到残差。
- Enc 编码残差;Dec 恢复重建残差。
- 将重建残差与相同预测帧相加,生成 x_hat_t。
橙色圆圈中的减号与加号,是这个框架中明确规定的图像域操作。中间的黑白竖条示意编码表示或码流,具体量化与熵编解码结构在后续方法图中展开。
右侧的数据流
- 从参考信息生成特征域上下文 x_bar_t。
- 当前帧与上下文共同进入 Enc。
- Dec 利用编码表示与同一上下文生成重建帧。
- 橙色虚线进一步把上下文送入熵建模环节。
右侧不再预先规定必须先在 RGB 域相减,最后再相加。网络可以学习如何把当前帧与参考信息共同转换为适合压缩的表示。上下文也并非只换成一张更好看的 RGB 预测图。
蓝色虚线框及其连线用于展示预测图或上下文特征的样貌,与橙色的条件信息连线区分。右侧的灰度特征图是特征表示的示意,不能凭这张小图给每个通道指定固定语义,也不能把示意图的张数当作实际通道数。
Figure 1 是框架概念图,没有单独画出运动估计、运动编码和全部辅助码流。它不能证明条件没有开销,也不能证明实际解码速度或画质收益。
引言第 3 段
英文短摘录: “What is condition?”
摘录翻译: “什么是条件?”
段落释义: 作者将条件定义为可学习的特征上下文,供编码器、解码器和熵模型共同使用,并以运动估计与补偿引导上下文生成。本段还报告相对 x265 veryslow 和 DVCPro 的码率优势。
条件是什么
预测图可以是一种条件,但作者不把条件限制为 RGB 图像。可将原文中的 x_bar_t 记为 c_t:它是一份帮助压缩当前帧的特征表示。
“维度可以灵活设计”表示表示形式及通道等维度可以由模型设计者选择,不意味着维度无限,也不意味着通道越多一定越省码率。把共享参考信息映射到更多通道,也没有凭空产生新的当前帧真实信息;优势在于使有限的网络更容易利用其中与当前内容相关的结构。
条件怎样参与三个环节
以下为教学用简化式,不是论文的编号公式,省略实际模型的其他先验与支路:
c_t:=\bar x_t,\qquad y_t=E_\theta(x_t,c_t),\qquad \hat y_t=Q(y_t),\qquad \hat x_t=D_\phi(\hat y_t,c_t).
E 为编码变换,D 为解码变换,Q 为量化;y_t 是潜在表示,y_hat_t 是其量化结果。theta 与 phi 表示网络参数。
| 参与位置 | 解决的问题 | 直观理解 |
|---|---|---|
| 编码器 | 在参考条件已提供信息的情况下,当前帧应该怎样表示? | 选择码流还需要传递什么 |
| 解码器 | 如何结合码流和参考条件重建当前帧? | 利用已有线索恢复内容 |
| 熵模型 | 量化符号在当前条件下出现的概率是多少? | 为表示分配更合适的码长 |
前两项决定表示与重建方式,第三项决定这些表示如何被压成比特。学习到有用的特征,不等于概率模型已充分利用特征;概率估计更准确,也不等于表示变换已经最合适。三个环节共同使用条件,正是本段强调的系统性设计。
在理想熵编码的近似意义下,某符号的码长与负对数概率有关:
\ell(\hat y_t,c_t)\approx-\log_2 p_\psi(\hat y_t\mid c_t,\ldots).
psi 表示概率模型参数,省略号表示实际模型还可能使用其他信息。这里并非论文完整概率分解。若自行构造一个例子:某个实际出现符号的模型概率由 1/8 提高到 1/2,其理想信息量由 3 bit 变为 1 bit。但总体收益取决于全部符号的平均负对数概率,不能用单个符号的变化代替实际码率实验。
所谓“熵模型随时间自适应”,在此是指条件特征随帧内容变化,预测的概率分布相应变化;不能直接理解为网络权重必须在每一帧在线更新。
条件怎样学得以及运动的作用
引言用 MEMC 概括运动估计与运动补偿。直观上,相机或物体运动后,当前帧某个位置的有用参考信息往往来自上一帧的另一个位置。运动信息帮助对齐这些位置。
自行构造一个例子:一辆车从左向右移动 5 个像素。当前车门位置对应的有用参考特征,应从上一帧左移 5 个像素附近寻找;直接取上一帧同坐标处的特征,可能取到车门的其他区域甚至背景。这个例子仅用于说明对齐动机,不是作者实验。
核查补充,Section 3.3 尚未计为精读: 为避免将引言的概述误读为“光流一定在特征上估计”,本轮核对了正式版第 6 页。实际方案由参考重建帧和当前帧估计运动,将运动编码并解码,再用解码后的运动引导参考特征的 warp 和后续细化。因而特征域对齐不等于取消运动估计,也不等于不需要运动码率。
解码器不能直接访问原始当前帧。需要用于解码的条件,必须能由双方共享的模型和已解码信息一致地得到;若生成条件需要传输运动等辅助信息,其开销必须计入总码率。Figure 1 省略了这些支路,后续 Figure 2 与 Section 3.3 再按顺序精读。
本段的实验数字
本段报告:对 1080p 标准测试视频,相比 x265 veryslow 节省 26.0% 码率,相比 DVCPro [4] 节省 16.4%。目前只将这两个数值记录为作者报告,质量指标、编码设置、统计方式和复现实验留到实验部分分析,不把它们解释为所有视频上的普遍收益。
引言第 4 段
英文短摘录: “a more comprehensive solution”
摘录翻译: “一种更全面的方案。”
段落释义: 作者承认已有工作 [15, 16, 12, 17] 研究过条件编码,将自己的区别定位在条件参与范围与可扩展性,并把更好的条件设计留作开放问题。
深入讲解: 不能把“提出条件编码概念”归为 DCVC 的首次贡献。本段的原创性主张包含两个层次:一是让条件同时参与编码、解码和熵建模;二是允许使用可学习的特征表示作为条件,而不将条件固定为某种单一形式。
作者对先前工作“仅覆盖部分模块,或需要人工规则筛选内容”的概括,属于需要核查的文献比较。应在 Related works 及相应文献中检查具体对象和差异,不能只凭引言就完成新颖性判断。
可扩展性意味着以后可以改变条件的定义、生成和使用方式。它是一项框架设计主张,不代表任意替换条件都会改善压缩,也不代表本文已找到最优条件。
贡献导语与四项贡献
以下按原列表顺序释义,属于作者的贡献主张,尚不等同于全部得到独立验证。
- 条件编码框架。 对条件的定义、使用和学习作系统设计,以提高压缩率。后续应检查与残差基线的比较及实现公平性。
- 条件参与三个环节及熵模型的取舍。 编码、解码和熵建模共同利用上下文;熵模型提供同时利用空间与时间相关性,以及仅利用时间相关性的设计选择,分别追求压缩率和速度。这里的“仅时间”针对熵模型中的相关性利用方式,不等于整套网络不处理空间结构,也不据此推断整套编解码器已实现实时运行。
- 特征域条件。 用较高维上下文提供更丰富的可用线索,帮助重建高频内容。其有效性仍要看表示维度、计算量、消融与重建结果。
- 框架可扩展。 条件的定义、使用和学习还可改进。这表明一个研究接口,不能与已经测得的性能提升混为一谈。
这四项并非完全独立的四个模块:框架概括整体设计,三个使用位置是实现方式,特征域是条件表示的选择,可扩展性描述以后能够改动哪些部分。
Introduction 结束后的整理
核心内容: 作者希望使参考信息不再只通过一张 RGB 预测图参与图像域的减加操作,而是通过可学习上下文共同影响表示、重建和概率建模。
逻辑链条: 残差框架限制了参考信息的使用形式 → 引言以条件熵说明进一步建模相关性的空间 → 定义特征上下文 → 用运动对齐提高相关性 → 将条件送入编码器、解码器和熵模型 → 由后续实验验证实际收益。
必须掌握: 三种符号 x_tilde_t、x_hat_t、x_bar_t 的区别;上下文在三个位置分别解决什么问题;条件要能在解码端重建;特征域对齐仍可能涉及运动码流;理论可行性、作者的新颖性主张与实验证据应分开判断。
理解检查: 如果只给熵模型输入上下文,另外两个模块能否自动获得同样的能力?如果某个条件只能在编码端访问,解码器能否使用它重建图像?Figure 1 能否单独证明实际码率与速度的提升?
阅读进度
- 本轮已完成:Figure 1 与图注;引言第 3 至 4 段、贡献导语及四项贡献。Introduction 全节已读完。
- 另行事实核查:Section 3.3 的运动估计输入及解码运动用于特征对齐;不计作该节精读完成。
- 当前停止位置:正式版第 2 页最后一项贡献末。
- 下一轮:正式版第 3 页 Section 2 Related works,从 Deep image compression 首段开始。
- 连续进度:DCVC 阅读记录。