来源:papers/iVc/DCVC_精读04_补充材料与总结.md · 原始 Markdown
DCVC 精读第 4 部分 补充材料与全篇总结
本部分接续 正文精读,按补充材料第 1 至 7 页顺序讲完全部 6 节、Figures 1 至 8、Table 1、脚注与参考文献,再给出全篇评价与复现路线。材料:补充 PDF。正文与补充材料图表编号独立,以下始终注明“补充”。
采用逐段释义与独立解释,不将网络论文长段转载或逐字全文翻译。模型训练、性能复现和主观视频评测均未实际执行;实验数值来自作者报告,代码核查范围单列。
补充材料开篇说明 第 1 页
开篇列出材料目的:补足网络结构、训练策略和额外实验。它不是一个新模型,与正文共同定义 2021 年 DCVC。以下不引入后续 DCVC 家族模型来替代本文配置。
Section 1 Network Architecture 第 1 至 2 页
补充 Figure 1 与对应段落 编码器和解码器
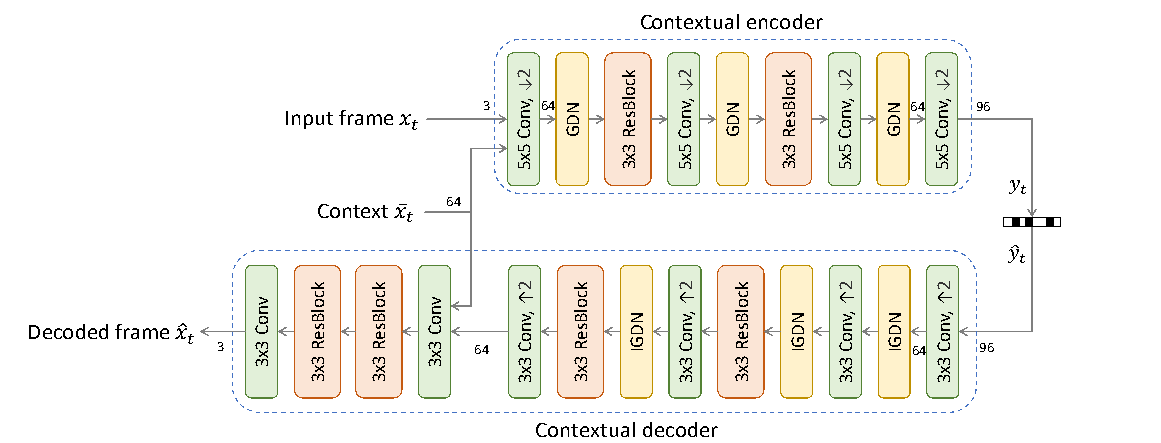
编码器将 RGB 当前帧与 64 通道上下文在通道维拼接,经过卷积、GDN 和残差块,形成每个空间方向下采样 16 倍、通道数为 96 的潜变量。四次 2 倍下采样得到 2^4=16;面积减少到 1/256,不是面积只减到 1/16。
以 NCHW 格式作教学示例,假设尺寸 H、W 能整除相应因子:
x_t:[B,3,H,W],\quad c_t:[B,64,H,W], \operatorname{concat}(x_t,c_t):[B,67,H,W], \quad y_t:[B,96,H/16,W/16].
解码器先将潜变量上采样回原分辨率特征,再与原分辨率上下文拼接,经卷积与残差块输出 3 通道重建图像。实际代码中相应的两组特征各为 64 通道,拼接后为 128 通道。上下文不仅影响压缩表示,也在最终重建阶段直接提供信息。
GDN 是广义除法归一化;可用下面常见形式建立直觉,属于补充知识,而非本文新提出的公式:
v_i=\frac{u_i}{\sqrt{\beta_i+\sum_j\gamma_{ij}u_j^2}}.
分母依赖多个通道的响应,帮助改变特征的统计结构。IGDN 用于对应的解码变换,但学习到的分析和合成链条加上量化,不保证严格数学可逆。残差块中的 shortcut 与“帧间残差编码”也不是同一个概念,不能因网络含 ResBlock 就说它仍是正文公式 1 的框架。
补充 Figure 2 与特征提取和细化段落
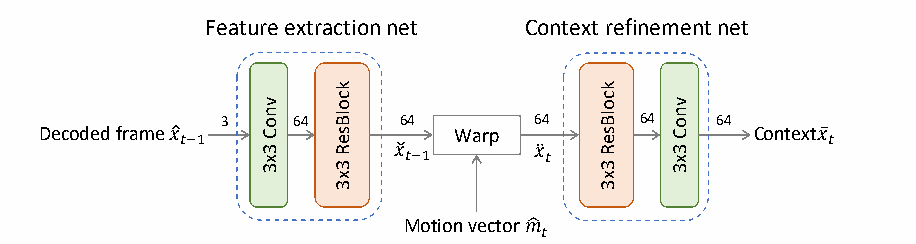
参考重建帧由 3 通道映射到 64 通道,特征提取网络由卷积与残差块构成;warp 使用解码运动进行特征对齐;上下文细化网络由残差块与卷积构成,输出仍为 64 通道。作者为控制复杂度没有使用更深的生成网络。此处是计算成本与表达能力的取舍,不证明浅网络已经最优。
运动生成段落
光流初始化使用 SPyNet 对应工作;运动编码、解码及运动细化网络沿用 DVCPro 的相应结构。它们是既有组件的使用,不应算作 DCVC 新发明的光流算法。要复现运动支路,必须补足被引用实现,而不能仅凭上下文生成图重建所有结构。
补充 Figure 3 与熵模型段落
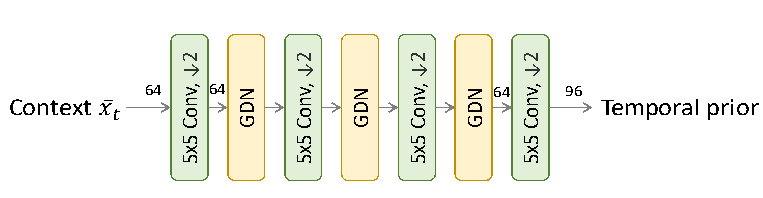
时间先验编码器由四次 stride=2 的 5×5 卷积和中间 GDN 组成,将 64 通道、原分辨率上下文转换到与图像潜变量相容的尺度,末端为 96 通道。超先验、自回归及融合网络承接联合自回归和层次先验的图像压缩结构。
必须区分两条熵编码支路: 图像潜变量使用超先验、空间先验和时间先验;运动潜变量另有熵模型,使用超先验与自回归,没有本文这个时间先验编码器。因此,删除图像潜变量的空间先验,不等于所有运动和内容码流都不含自回归处理。
Section 2 Progressive training 第 2 至 3 页
前两个段落先明确总码流,再解释直接联合训练的失败现象。四种量化码流分别是:
| 论文符号 | 内容 | 作用 |
|---|---|---|
| y_hat_t | 图像内容潜变量 | 表示当前帧需要编码的内容 |
| z_hat_t | 图像超先验 | 帮助解码图像潜变量的分布 |
| g_hat_t | 运动潜变量 | 恢复运动信息 |
| s_hat_t | 运动超先验 | 帮助解码运动潜变量的分布 |
对于一个 P 帧,完整训练码率为这四项之和。整个视频的码率还要计入 I 帧;完整文件还可能存在头信息、封装等开销。
作者报告:即使使用预训练光流初始化,直接优化全部损失也可能出现运动码率很小、总体率失真却很大的结果。作者解释为模型倾向绕开较难学好的运动补偿路径。这是训练过程的局部失败模式,不是条件编码理论本身要求忽略运动。
补充 Table 1 四阶段目标
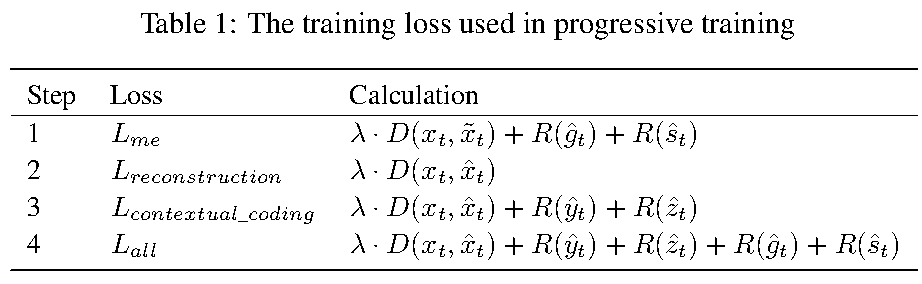
L_{\rm me}=\lambda D(x_t,\tilde x_t)+R(\hat g_t)+R(\hat s_t), L_{\rm reconstruction}=\lambda D(x_t,\hat x_t), L_{\rm contextual\_coding}=\lambda D(x_t,\hat x_t)+R(\hat y_t)+R(\hat z_t), L_{\rm all}=\lambda D(x_t,\hat x_t)+R(\hat y_t)+R(\hat z_t)+R(\hat g_t)+R(\hat s_t).
四个 Step 按原顺序解释:
- 运动预热。 训练运动估计、运动编码与解码,以解码运动对参考图像做像素域 warp,所得预测图与当前图像比较,同时计入运动码率。此处使用像素域预测损失训练运动,不与最终特征域补偿冲突。
- 冻结运动,先学重建。 训练依赖上下文的重建链条,只追求失真下降,暂不加入内容码率压力。这样先让上下文有实际用处。
- 冻结运动,加入内容码率。 在前一阶段基础上加入图像内容与图像超先验的比特成本,学习更紧凑的表示。
- 解冻运动,端到端优化。 使用四项码率的完整目标,使运动质量、运动开销和内容开销共同协调。
最后一段报告单张 Tesla V100 约一周训练,并说明 DVCPro 也采用渐进训练重新训练,DVC 使用公开模型。论文未在该段明确这个时间涵盖多少个质量模型,也未完整列出阶段时长;不能把它扩展成所有工作点总共一周的确定预算。
本节必须掌握: 好的优化目标不保证从任意初始化都容易学到好解;四阶段分别解决运动可用性、重建可用性、可压缩性和联合权衡。
Section 3 Details of experimental settings 第 3 页
数据集段落及脚注
作者说明训练与测试数据来源,并在脚注列出 Vimeo 数据仓库许可证、MCL-JCV 页面、UVG 的 BY-NC 链接及 CompressAI 许可证链接。这些是补充材料发表时的来源说明,本文未另行审计现时授权条款。作者还声称人工检查数据内容;该声称不等于本次阅读者重新完成了数据检查。
I 帧及模型档位两段
MSE 使用 cheng2020-anchor,MS-SSIM 使用 hyperprior。CompressAI 的 quality 3、4、5、6 依次匹配 DCVC 的四个 lambda 档位;例如最高档对应 MSE lambda=2048 或 MS-SSIM lambda=64。比较 P 帧模块时,应匹配 I 帧模型,不能将 I 帧质量提升错误归因于上下文设计。
FFMPEG 设置段落与命令列表
作者的命令使用输入 yuv420p、明确尺寸与帧率、veryslow、固定 QP 与 GOP;x264 命令还给出 bf=2、b_strategy=0、sc_threshold=0,x265 通过 qp 和 keyint 参数传递工作点与 GOP。两条命令均出现 zerolatency。复现时必须保留整套参数并检查真实帧型,不能只凭某个 tune 名称认定两个传统基线都采用相同参考结构。
文中的 W、H、FR、N、QP、GOP 分别是宽、高、帧率、编码帧数、量化参数和图像组长度。这些占位符不是可原样执行的真实数值。
GOP 与帧数段落
主实验 HEVC:GOP=10,100 帧;MCL-JCV 和 UVG:GOP=12,120 帧,各 10 个 GOP。它与下一节长 GOP 测试所用帧数不同。必须让传统与神经方法处理相同裁剪区域、相同帧序列和相同数量的帧,并统一颜色转换、PSNR 通道口径与 I 帧计入方式。
Section 4 Test on larger GOP size 第 3 至 5 页
补充 Figure 4 与长 GOP 的两个段落
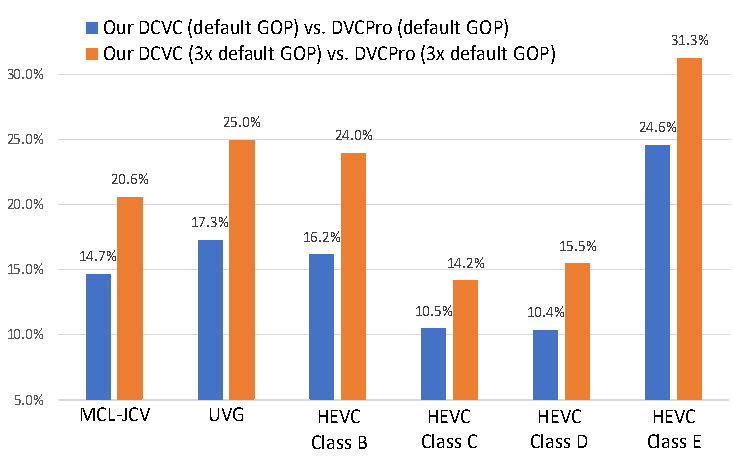
图中锚点是对应 GOP 配置下的 DVCPro,不能与正文以 x265 为锚点的 Table 1 混读。HEVC 的 GOP 从 10 增至 30,其余从 12 增至 36;两种 GOP 比较均只测试 HEVC 30 帧、其余 36 帧。
| 数据集 | 默认 GOP 的节省 | 三倍 GOP 的节省 |
|---|---|---|
| MCL-JCV | 14.7% | 20.6% |
| UVG | 17.3% | 25.0% |
| HEVC B | 16.2% | 24.0% |
| HEVC C | 10.5% | 14.2% |
| HEVC D | 10.4% | 15.5% |
| HEVC E | 24.6% | 31.3% |
每组中 DCVC 相对 DVCPro 的节省随 GOP 增大而增加,支持作者关于更好应对参考误差传播的解释。但更大相对优势不等于 DCVC 自身在长 GOP 下绝对质量一定不下降。默认配置 B 的 16.2% 与引言的 16.4% 也不应直接认定为同一次统计:这里 HEVC 仅测试 30 帧,主实验是 100 帧。
补充 Figure 5 与个例段落
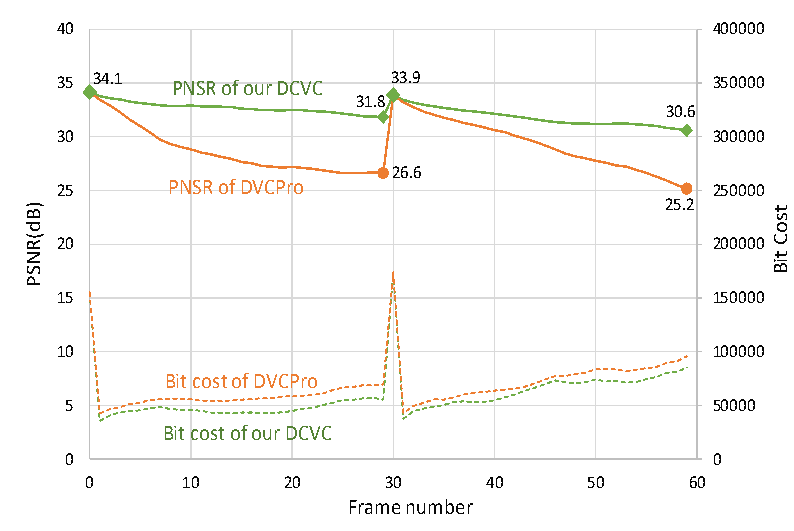
该图为 BasketballDrive,GOP=30,测试 60 帧。横轴是帧位置,左轴 PSNR,右轴每帧比特成本,实线表示质量、虚线表示比特。第一 GOP 中 DVCPro 从 34.1 dB 降到 26.6 dB,DCVC 降到 31.8 dB;第二 GOP 结束处图中标注为 25.2 dB 与 30.6 dB。I 帧附近质量回升且出现比特峰值,符合周期性刷新参考的作用。
【独立分析】该个例与六个集合上的长 GOP 比较共同支持缓解误差传播,但不能说已经消除了误差传播,也不能代替专门的闪烁或时间稳定性指标。正文自己明确把时间稳定性留为未来问题。
Section 5 Ablation study 第 5 至 6 页
补充 Figure 6 与通道维度段落
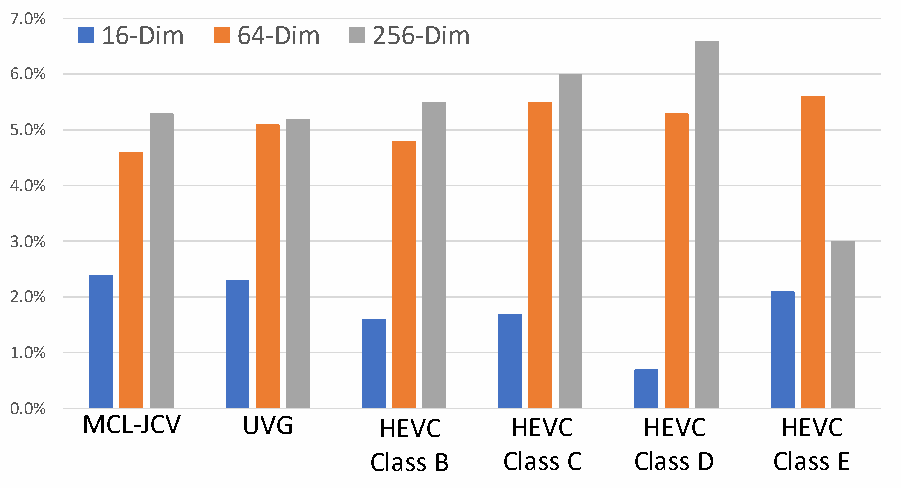
锚点为 3 通道模型,比较 16、64、256 通道。16 通道带来一定改进,64 通道通常进一步改善,256 通道增益有限且在 HEVC E 上明显不如 64 通道。图中 E 的 256 通道相对 3 通道仍有正收益,因此“性能下降”应明确比较对象,不能误写为已经差于 3 通道。
作者推测高维、原分辨率上下文缺少额外监督时训练可能不稳定。这是可能解释,图本身没有排除过拟合、优化难度、容量分配等其他因素。默认选择 64 通道体现收益与成本的折中。
补充 Figure 7 与移除 MEMC 的两段
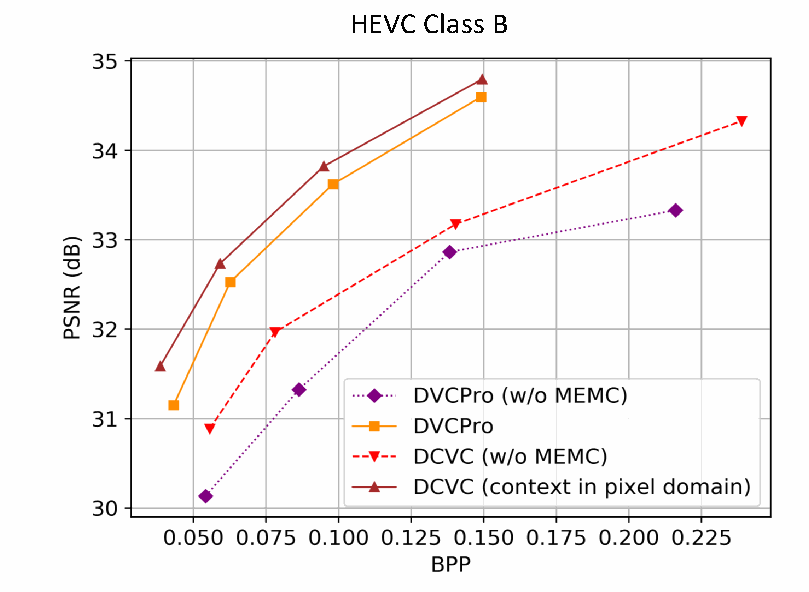
为控制条件表示的差别,实验使用像素域条件的 DCVC 变体,与 DVCPro 比较;去掉 MEMC 后,直接把上一重建帧当条件或预测图。两种框架都显著变差,说明运动对齐仍然重要。
在 HEVC B 上,有 MEMC 时像素域条件 DCVC 比 DVCPro 节省 12.7%;无 MEMC 时比对应无 MEMC 的 DVCPro 节省 22.1%。这是两种配对比较,不能解释为“去掉 MEMC 后 DCVC 本身变得更好”。后面的未来工作段提出更大感受野等学习方式,属于方向设想,不是本文已实现的 Transformer 编码器。
Section 6 Visual comparison 第 6 至 7 页
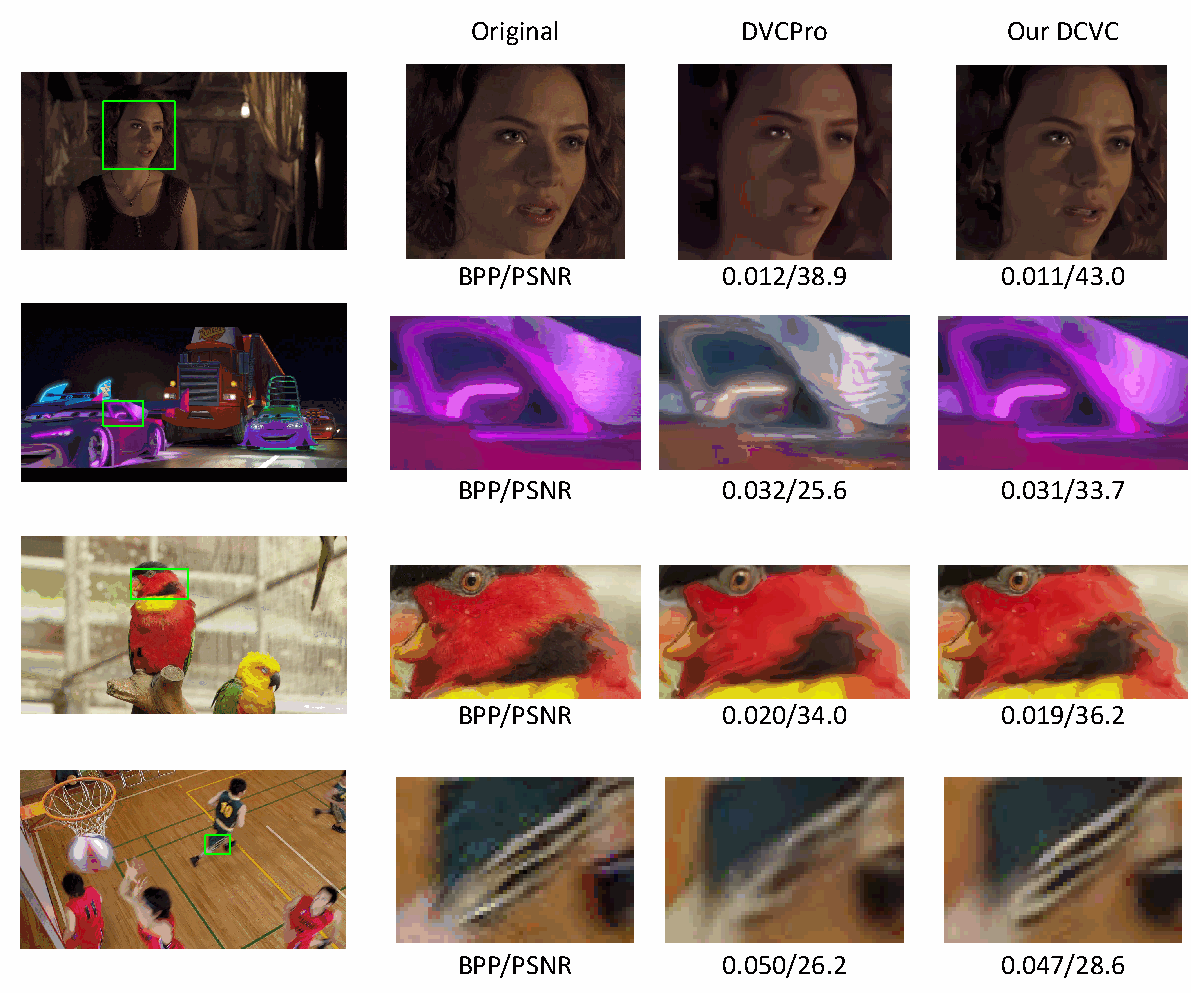
四列依次是完整原图、原图裁切区域、DVCPro、DCVC。正文跨页的两段强调颜色、异常纹理与条纹细节。图中标注的结果如下,单位为 BPP / PSNR(dB):
| 行 | DVCPro | DCVC |
|---|---|---|
| 人像 | 0.012 / 38.9 | 0.011 / 43.0 |
| 彩色车辆 | 0.032 / 25.6 | 0.031 / 33.7 |
| 鸟 | 0.020 / 34.0 | 0.019 / 36.2 |
| 篮球场景 | 0.050 / 26.2 | 0.047 / 28.6 |
这些个例显示较低 BPP 下获得更好的标注质量与局部观感。它们是挑选出的展示,不是全测试集的均值或盲测人类偏好;图注也不足以把每个标注 PSNR 确定解释为仅裁切小块的 PSNR。
补充材料最后列出 15 项参考文献,其中 Transformer 综述仅服务于未来方向。书目信息保留于 参考文献核查表,不把被引文献都算作本次全文精读对象。
全篇科研评价
基本信息与一句话概括
Jiahao Li、Bin Li、Yan Lu,Microsoft Research Asia,NeurIPS 2021。DCVC 将由重建参考帧和解码运动生成的特征上下文,共同送入编码器、解码器和熵模型,在实际学习式视频压缩系统中验证条件表示的作用。
背景 核心问题 与创新边界
问题是怎样在同等重建质量下减少视频总码率。作者挑战的是固定图像域残差结构对参考信息使用形式的限制,并从条件定义、参与环节和学习方式三个角度提出方案。
真正值得借鉴的是三个环节共享条件与特征域上下文的系统设计。条件编码概念、超先验、自回归、光流、卷积、GDN 及通用率失真目标均已有基础。理论上给定预测后的残差与原信号可逆,不能把引言不等式解读为所有残差模型都必然严格劣于条件模型。
完整方法链条
第一帧用图像编码器形成参考;后续帧估计并编码运动,用解码运动对参考特征做 warp 与细化;当前帧与上下文形成图像潜变量;超先验、空间先验和时间先验共同估计符号分布;传输四路潜变量后,在解码端以同一参考和已解码信息重建上下文,恢复当前帧并递推。
最有说服力的证据
一是主表六个集合相对 x265 veryslow 的结果;二是 Table 2 对条件形式与时间先验的拆分;三是 Table 3 和长 GOP、MEMC、通道数实验,对概率建模、运动对齐与表示容量提供互补证据。所有数据均为论文报告,本次没有训练或重新跑分。
优势与局限
- 覆盖三种信息使用位置,条件表示灵活;但模块与容量同时变化时,不能把全部收益都归给单个机制。
- 使用重建参考和解码运动,具备可解码的因果结构;仍有运动、超先验与顺序解码等成本。
- 在本文数据与设置下优于主要基线;没有证明优于所有传统编码配置或 VVC,也不代表任意视频都节省 26%。
- I 帧控制和多数据集测试增强可信度;尚未报告重复训练方差、系统性的失效分布或全面端到端速度曲线。
- 长 GOP 实验支持缓解误差传播;未专门优化或完整评估时间稳定性。
- 默认单参考帧,通道可能冗余,256 通道并非更好;这些是可继续研究的明确接口。
复现路线与本次代码核查范围
2026-10-15 核对的官方入口为 microsoft/DCVC 的 2021 子目录,不能照仓库根目录后续模型的配置复现本文。原始文档给出的环境为 Python 3.8、CUDA 11.0、PyTorch 1.7.1;这只是其历史配置,不声称当前系统可直接无改动安装。
具体只读核查了 README、test_video.py 和 DCVC_net.py。未安装依赖、下载权重、执行外部代码或完成编解码测试。
最小路线是:
- 固定 2021 版本与模型档位,先准备一段短序列及对应 I 帧模型。
- 按该子目录要求统一尺寸;README 示例把 1920×1080 裁为 1920×1024,并要求空间尺寸为 64 的整数倍。传统基线必须使用相同裁剪,不能混用像素区域。
- 用一个质量模型完成完整 GOP,检查重建参考递推、四项 BPP 和质量指标是否合理。
- 显式开启 write_stream=true 检查真实码流与解码;测试脚本默认 false,走概率估计的 forward 路径。输出重建帧也有独立选项。
- 模型实际码流路径有 encode_decode、compress、decompress;解码阶段从参考帧和码流生成上下文,验证这个数据依赖,不以只有 forward 输出当作独立可解码性的证明。
- 区分概率估计、四段 payload 长度与完整文件字节数。当前核查实现的 compress 返回四段 payload 长度之和,头信息或封装是否计入需单独核对,即使开启写流也不应直接把日志 BPP 当成完整文件大小。
- 在四个工作点上统一 I 帧、GOP、帧数、裁剪、颜色转换、质量统计,再比较曲线与 BD-Rate。最后复现 Table 2、Table 3,分别检查条件与先验的效果。
可执行的延伸实验
以下是从本文出发的实验设计,未声称具有当前年份的新颖性:
| 研究问题 | 可检验假设 | 最小实验与评价 |
|---|---|---|
| 哪些上下文通道真正有用 | 部分通道冗余,适当压缩通道可保留大部分收益 | 在 16/64 通道之间作受控裁剪或门控,统一训练预算,比较 BD-Rate、显存、实际耗时 |
| 遮挡或场景切换时是否仍过度依赖参考 | 按参考可靠性调整条件能改善困难区域 | 构造遮挡和切换分组,记录四路码率、区域失真与失败样本 |
| 多参考信息是否值得其开销 | 更广参考有收益,但运动与计算成本可能抵消 | 同训练预算、同总码率,比较单/多参考,不能只比较内容潜变量比特 |
| 能否兼顾跨帧稳定性 | 加入时间一致性目标可降低闪烁但可能损失逐帧率失真 | 在同码率下同时报告逐帧指标、运动补偿后的时间误差及视频观察结果 |
知识体系与学习顺序
先掌握熵、条件熵、交叉熵与 KL,再掌握图像压缩的变换、量化和概率质量;随后理解超先验与自回归;最后串联光流、warp、参考递推、完整码流、率失真训练和 BD-Rate。这里的空间上下文主要来自当前潜变量中已解码的符号,时间条件主要来自参考信息;来源和可用时刻不能混淆。
完成状态
前两轮已完成标题至 Introduction;本次第 3、4 部分完成正文余下全部章节、40 项正文参考文献的条目核对、7 页补充材料及其 15 项参考文献条目,覆盖正文公式 1 至 7、Figures 1 至 7、Tables 1 至 3,以及补充 Figures 1 至 8、Table 1。没有遗漏等待继续讲解的论文结构单元。
这是论文与补充材料的讲解完成,不是实验复现完成,也不是所有被引论文的全文阅读完成。可继续研究的问题不作为“尚未讲完”的内容。